×

 سمینار مروری بر سیستم های تشخیص چهره و الگوریتم های یادگیری
 سمینار بررسی پروتکل های انتقال اطلاعات در شبکه های VANET
 سمینار تدابیر ایمنی و امنیتی پدافند غیر عامل در محیطهای IT
 سمینار امنیت اطلاعات و حفاظت داده ها در پایگاه داده
 سمینار بررسی روش های خوشه بندی توزیعی
 سمینار ردیابی اشیا متحرک در شبکه های حسگر بی سیم
 سمینار موازی سازی الگوریتم Ant Colony و کاربرد آن در امنیت شبکه
 ماشین حساب مهندسی با زبان سی شارپ
 سمینار استفاده از گراف ها در تشخیص الگوها
 سمینار سیستم های وب کاوی چند عامله سمینار تدابیر ایمنی و امنیتی پدافند غیر عامل در محیطهای IT سمینار مروری بر سیستم های تشخیص چهره و الگوریتم های یادگیری سمینار بررسی پروتکل های انتقال اطلاعات در شبکه های VANET سمینار ردیابی اشیا متحرک در شبکه های حسگر بی سیم
 نمونه سوال های استخدامی شرکت فولاد کاوه اروند و وزارت نیرو برای سال 97 سمینار امنیت اطلاعات و حفاظت داده ها در پایگاه داده
 سمینار تست معماری های سرویس گرا
 سمینار امنیت پایگاه های داده در مقابل حملات داخلی و خارجی سمینار استفاده از گراف ها در تشخیص الگوها سمینار موازی سازی الگوریتم Ant Colony و کاربرد آن در امنیت شبکه سمینار سیستم های وب کاوی چند عامله
 سمینار تعامل بین جاذب های اجزاء چهره و جاذب های چهره کامل در قشر گیجگاهی مغز
 فروش فیلتر بورسی استریکلی فقط 75 هزار تومان
 کسب درآمد اینترنتی 300000 تومان در خانه در کمتر از 30 دقیقه
 کسب و کار اینترنتی با درآمد میلیونی
 روش درآمدزایی در خواب (تعجب نکنید! کلیک کنید و بخوانید)
 ربات همه کاره اینستاگرام
 کسب درآمد از هوش مصنوعی ماهیانه حداقل ۱۲ میلیون تضمینی
 کسب درآمد روزانه حداقل یک میلیون تومان ! کاملا حلال و واقعـی !!
 کسب درآمد ابدی و بی نهایت 100% واقعی
 مجموعه ی آموزش تعمیر لامپ کم مصرف (از مبتدی تا پیشرفته)
 افزایش ممبر کانال، گروه و ربات تلگرام به صورت بی نهایت (اد ممبر)
 دانلود مجموعه آموزشی پایپینگ ( Piping ) و نقشه خوانی + آموزش سه نرم افزار طراحی و تحلیل لوله کشی صنعتی
 آموزش برنامه نویسی آردوینو
 آموزش رایگان کسب درآمد از سایت الیمپ ترید ( olymp trade )
 آموزش بازكردن انواع قفل ها بدون كليد(ويژه)
 کسب و کار اینترنتی در منزل
 بازگردانی پیامک های حذف شده- ریکاوری پیامک ۱۰۰٪ عملی
 اموزش ویرایش امضا و پکیج برنامه اندروید و کسب درامد از مارکت های اندرویدی
 آموزش ساخت بازی بدون دانش برنامه نویسی و طراحی سه بعدی مبتدی تا پیشرفته با نرم افزار
 اموزش کسب درامد از اینترنت روزانه ۳میلیون تومان تضمینی و تست شده 1403
 کد های آماده html و css جهت یادگیری و طراحی سریع
 درامدزایی در خواب! (تعجب نکنید! بخوانید)
 نسخه خطی اشعار و پیشگویی های شاه نعمت الله ولی
 آموزش كامل تعمير لامپ كم مصرف(اختصاصي)
 نسخه خطی اشعار و پیشگویی های شاه نعمت الله ولی
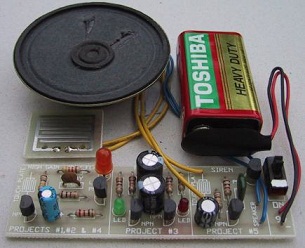 مدار داخلی واکی تاکی(اموزش ساخت)
 کتاب افزایش ممبر کانال تلگرام
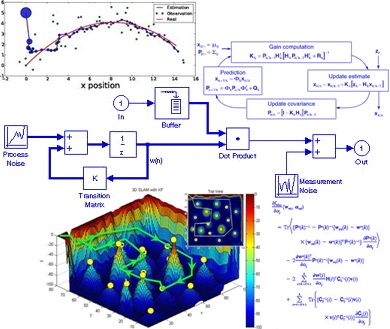 دانلود پاورپوینت فیلتر کالمن بر روی یک سنسور شتاب سنج برای تخمین سه متغیر حالت
 اندیکاتور ای کیو آپشن
 دانلود100% رایگان نرم افزار تبلیغات در تلگرام + آموزش کامل و فیلم آموزشی
مقطع تحصیلی: کارشناسی ارشد
رشته تحصیلی: کامپیوتر
چکیده:
چگونگی سازماندهی و ادغام نتایج پرسوجوی بازیابیشده از منابع مختلف، یکی از موضوعات کلیدی در بازیابی اطلاعات توزیعی است. برخی از پژوهشها و آزمایشات پیشین توصیه میکنند که مرور اسـنادی که به صورت خوشه بیان میشوند به نسبت اسنادی که تنها در یـک لیـست مطـرح مـی شـوند کـارآیی بیشتری دارند. ارائه ی نتایج بازیابی به صورت خوشه مبتنی بر فرضیه ی خوشه است. بر طبق این فرضـیه، وضعیت اسناد درون یک خوشه ارتباط مشابهی با پرسوجوی مطرح شده دارند. خوشه بندی میتواند به عنوان فرآیند بخشبندی یک مجموعه از الگوها به گـروههـای معنـادار همگـن و منفصل به نام خوشه ها تعریف شود. در خوشه بندی داده هـای توزیـع شـده، مجموعـه ی داده هـا در میـان چندین سایت توزیع شده اند. خوشـه بنـدی در حـوزه هـای کـاربردی مـدرن مثـل تعـاون در خریـد و فـروش ، بیولـوژی مولکـولی و چندرسانه ای وظیفه ای مهم بر دوش دارد. در بسیاری از این حـوزه هـا ، اساسـا اطلاعـات از سـایتهـای مختلفی گرفته میشود. برای اقتباس اطلاعات از این داده ها ، آنها به صورت یک مجموعـه درآمـده انـد و خوشه بندی میشوند. در سالهای اخیر، پیشنهاداتی برای اکتشاف دانش و کاوش داده ها، و به ویژه برای خوشه بندی گـسترش یافته اما تنها تعداد کمی از آنها برای منابع داده ای توزیع شده اسـت. در ایـن تحقیـق، یـک مـروری بـر الگوریتم های خوشه بندی توزیعی مطرح شده است.
نوع فایل: PDF
تعداد صفحات: 82
برچسب های مهم